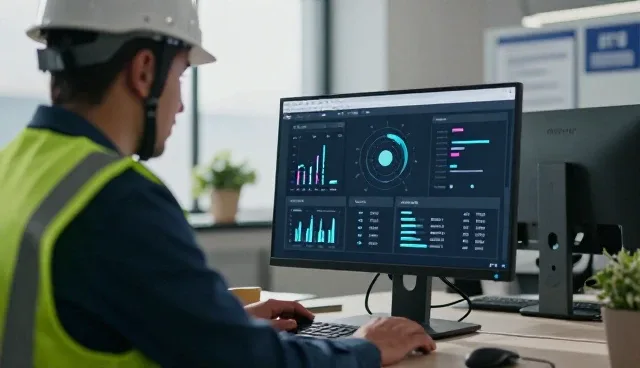
在数据采集与处理过程中,数据清洗是确保数据质量的关键环节。然而,许多企业在实际操作中常常遇到数据不一致、重复记录、格式错误等问题,这些都可能影响后续的数据分析与应用效果。以临沂市大数据协会的实践为例,智能数据采集系统在运行初期便遇到了大量因数据清洗不充分导致的数据异常,进而影响了系统的稳定性与效率。这说明,数据清洗不仅是技术操作,更是对业务流程与数据规范的深度理解。因此,针对常见的数据清洗问题,建立系统的处理方法尤为必要。
数据不一致是数据清洗过程中最常见的问题之一。在实际业务场景中,由于数据来源不同、字段定义差异或数据录入方式不统一,同一字段可能会出现多种表达方式。例如,某企业内部系统中,客户地址字段可能存在“山东省临沂市兰山区”与“山东临沂兰山”两种写法,这种不一致性不仅增加了数据处理的复杂度,还可能导致后续分析时的误判。为解决这一问题,智能数据采集系统引入了自动匹配与标准化处理机制,通过预设的规则库和自然语言处理技术,将不同格式的数据统一为标准形式。
重复记录也是数据清洗过程中需要重点处理的问题。尤其是在数据采集系统接入多个数据源时,同一记录可能因不同渠道的录入而产生多个副本。例如,某企业通过智能数据采集系统采集客户信息时,由于不同部门使用不同的系统进行录入,导致同一客户的多份记录被重复存储,影响了数据的准确性与完整性。针对这种情况,系统引入了基于唯一标识符的去重算法,结合用户身份信息与历史记录,实现对重复数据的精准识别与删除。同时,系统还提供了数据溯源功能,确保在去重过程中不影响原始数据的完整性。
数据格式错误是另一类常见的清洗问题,尤其在处理非结构化数据时更为突出。例如,某企业在使用智能数据采集系统采集用户反馈数据时,发现部分字段中存在非法字符或不符合格式要求的内容,如日期字段中出现“2023-02-30”等无效日期。这类问题不仅影响数据的可用性,还可能导致后续分析工具的运行异常。为此,系统在数据采集阶段便引入了格式校验机制,通过正则表达式和类型判断,对数据格式进行实时检查,并在发现错误时自动标记或拒绝接收。同时,系统还支持异常数据的自动归类与人工复核,确保数据清洗的全面性与准确性。
在数据清洗过程中,数据缺失也是一个不可忽视的问题。特别是在采集外部数据或用户填报数据时,某些字段可能因用户未填写或系统未记录而出现空值。这类缺失数据不仅会影响分析结果的可靠性,还可能误导业务决策。以临沂市大数据协会的项目为例,智能数据采集系统在初期因部分字段缺失导致分析结果偏差。为解决这一问题,系统引入了数据补全机制,结合历史数据、业务规则和用户行为分析,对缺失字段进行智能推测与填充。同时,系统还支持用户手动补充数据,确保数据的完整性与灵活性。
此外,数据清洗还涉及数据类型的转换与标准化。例如,某企业采集的销售数据中,部分字段以字符串形式存储,而后续分析需要数值型数据,导致计算异常。智能数据采集系统在数据采集阶段便对数据类型进行了预处理,将文本字段自动识别并转换为相应的数值类型,同时提供数据类型映射配置功能,使用户能够根据业务需求灵活调整。这种前置处理不仅提升了数据处理的效率,也减少了后期数据清洗的工作量。
在数据清洗过程中,系统还引入了动态更新机制,以应对数据源变化带来的新问题。例如,随着业务发展,某些字段的定义可能发生变化,如从“联系电话”变为“联系方式”,系统能够自动识别这一变化并更新相应的清洗规则。同时,数据清洗过程也支持用户自定义规则,允许企业根据自身需求调整清洗策略,提升系统的适应性与灵活性。
综上所述,数据清洗是数据结构优化的重要一环,其核心在于识别与解决数据质量问题。通过智能数据采集系统的自动清洗、规则配置和动态更新机制,企业在数据处理过程中能够更高效地应对各类数据问题,从而提升数据的可用性与分析价值。在实际业务中,数据清洗不仅需要技术手段的支持,更需要对业务流程与数据规范的深入理解,才能实现数据价值的最大化。